Webben stänger dörrarna för AI-agenter
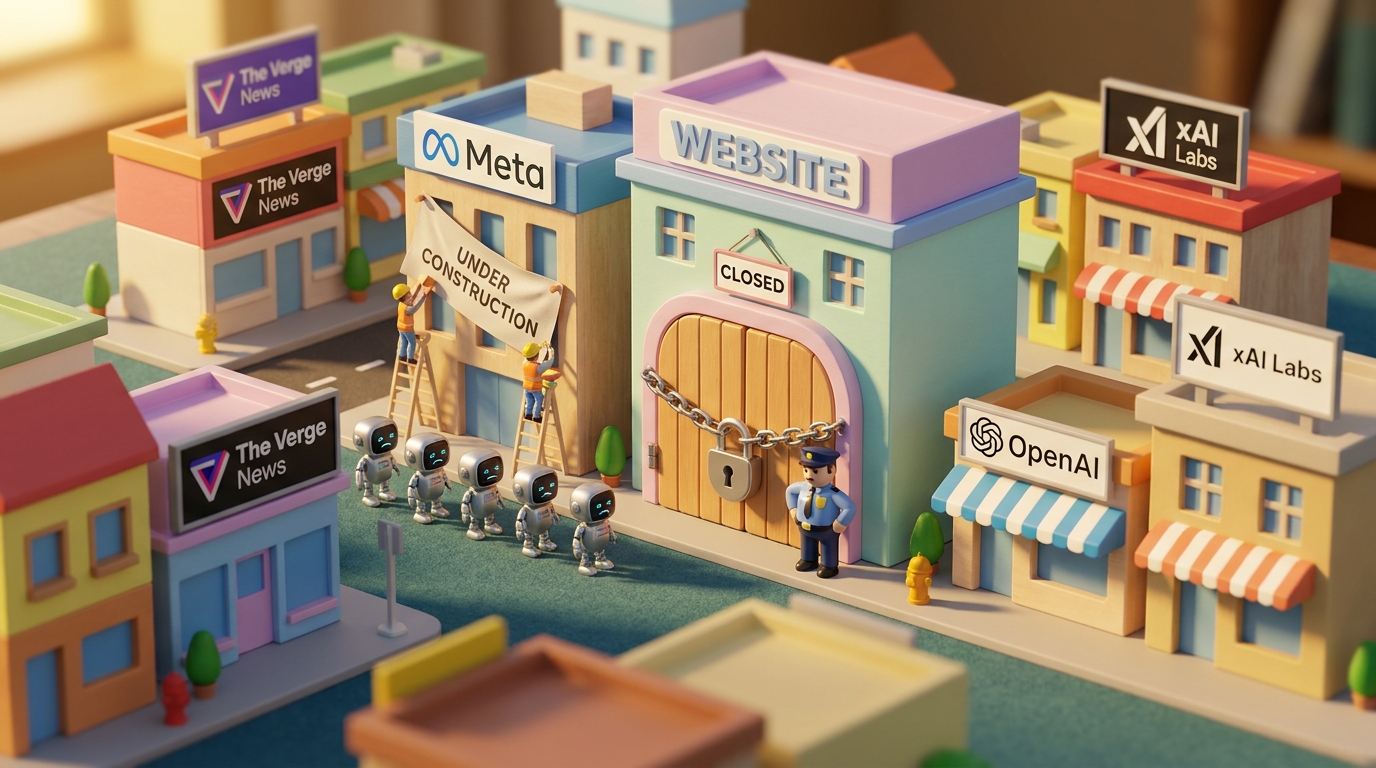
Det visar sig att "agenter som gör allt åt dig" förutsätter att webben faktiskt vill låta dem in. Det vill den inte.
Under de senaste veckorna har användare av Meta Muse, Grok, OpenAI Dots och Instinct stött på blockeringar när deras agenter försökt utföra uppgifter på stora sajter. Yelp kräver att AI-agenter tecknar datalicensavtal för att ens få titta på recensioner. Delta blockerar dem från att boka biljetter. Det här är inte kantfall — det är en strukturell konflikt som just börjat ta form.
Parallellt med det försökte Meta göra något mer subtilt. Den 30 oktober skulle nya användarvillkor träda i kraft med en formulering som i praktiken gav Meta rätt att skrapa och träna på innehåll från sajter kopplade till annonsörer på plattformen, inklusive nyhetsutgivare. Logiken var elegant på ett läskigt sätt: om du annonserar hos Meta och accepterar deras kommersiella villkor, kan Meta hävda att det ger dem tillgång till din sajt, oavsett vad din robots.txt-fil säger.
Det höll i ungefär 48 timmar. Efter kritik från mediabranschen och Cornell-professorn James Grimmelmann tog Meta bort formuleringen. Utan förklaring. Utan att svara på om de faktiskt använde möjligheten, eller bara testade hur mycket de kunde ta.
Det finns två separata problem här som pekar åt samma håll. Sajter vill kontrollera hur deras data används, och AI-bolagen vill ha fri tillgång till allt. Den spänningen löser sig inte av sig själv. Robots.txt har aldrig haft juridisk status, och det är uppenbart att ingen är helt säker på vad som faktiskt gäller när en AI-agent bokar ett bord, köper en sko eller drar information från en artikeltext.
För den som bygger produkter med agenter är det här relevant nu. Vad händer när din agent träffar på en paywall, en blockering eller ett företag som plötsligt kräver licensavtal? Den tekniska lösningen är enkel att se, betalflöden och fallbacks. Det juridiska och kommersiella lagret är inte det. Och det lagret håller på att uppfinna sig självt i realtid.